IBM zette op 25 augustus 2026 de gewichten van Granite 4.2 online. De release bevat een familie van modellen met circa 3 miljard, 8 miljard en 30 miljard parameters, aangeboden onder de Apache 2.0-licentie. In de documentatie en begeleidende tutorials ligt de nadruk op het lokaal aanpassen van het model — finetunen — en op mechanieken voor redeneergedrag en agentachtige training.
Waarom het 8B-model centraal staat
Van de drie maten in de Granite-familie wordt het 8B-model expliciet gepositioneerd als pragmatische keuze: groot genoeg om nuttig te zijn voor domeinspecifieke taken en tegelijk compact genoeg om op een enkele consumenten-GPU gefinetuned te worden. Dat verlaagt de drempel voor organisaties en individuele ontwikkelaars die niet over omvangrijke cloudbudgetten beschikken maar wel maatwerk-AI willen inzetten.
Complete finetuning-workflow voor ontwikkelaars
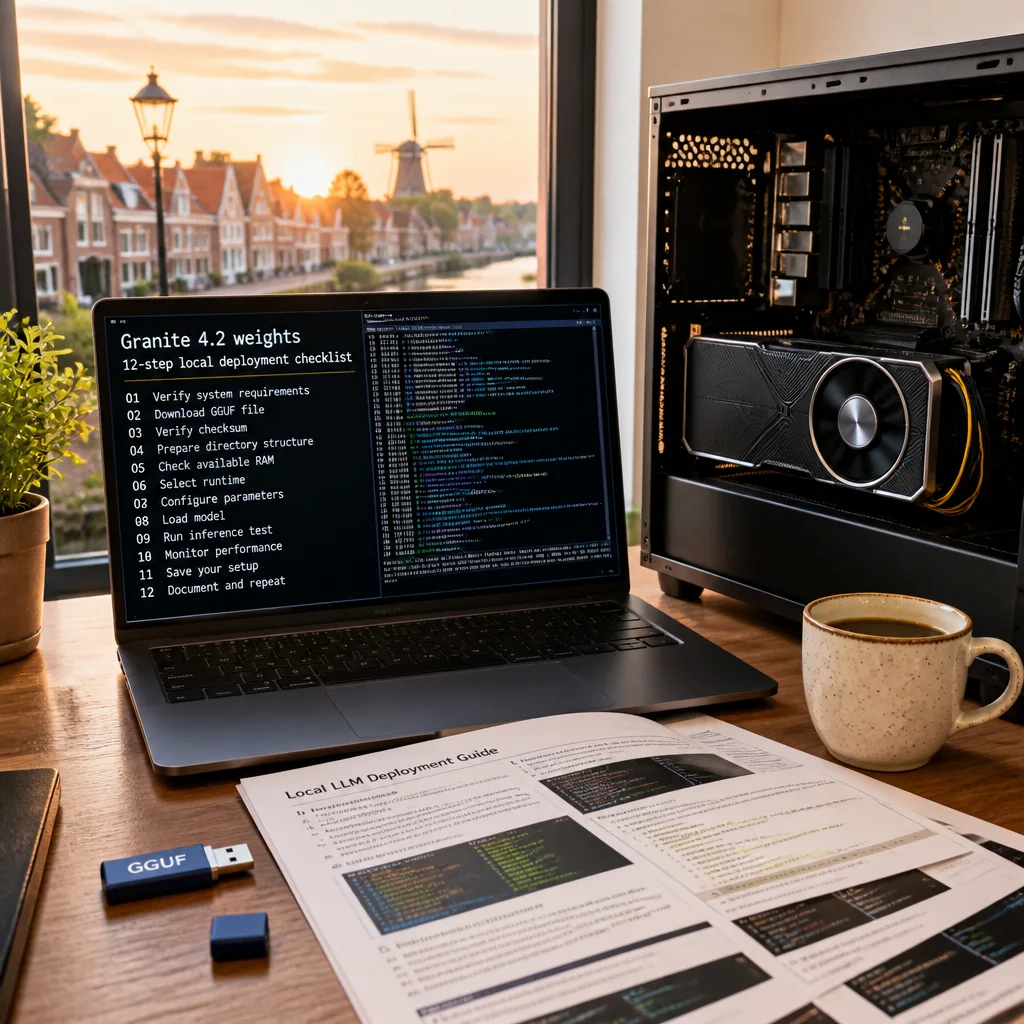
De aangeleverde tutorial beschrijft een volledige keten van stappen, van het opzetten van een schone Python-omgeving tot het exporteren van het uiteindelijke model voor lokaal gebruik. Belangrijke onderdelen uit de workflow zijn:
- installatie van dependencies en versievoorwaarden;
- inloggen bij repositories zoals Hugging Face en het downloaden van de gewichten;
- laden van het model met 4-bit-quantisatie (QLoRA-configuratie) om geheugenverbruik te reduceren;
- configureren van LoRA-adapters met PEFT voor efficiënte parameteraanpassing;
- voorbereiden van trainingsdata met aandacht voor dataprivacy en AVG-conformiteit;
- monitoring van trainingsvoortgang, evaluatie en export naar formaten als GGUF voor gebruik met tools als llama.cpp of Ollama.
De tutorial telt in totaal 12 stappen, inclusief troubleshooting, evaluatie met benchmarks en tips om veelvoorkomende valkuilen te vermijden. Er wordt ook een compleet werkend projectscript meegeleverd dat al deze stappen samenvoegt.
Privacy, AVG en praktische consequenties
IBM positioneert Granite 4.2 expliciet voor lokale inzet en domein‑specifieke toepassingen. Dat heeft twee duidelijke gevolgen: enerzijds maakt open toegang tot gewichten maatwerk mogelijk voor bedrijven die gevoelige data niet willen delen met publieke cloudproviders; anderzijds verlegt het de verantwoordelijkheid voor AVG-conforme verwerking en beveiliging van trainingsgegevens naar de organisatie die finetuned. De tutorial benoemt dataprivacy als onderdeel van de workflow en geeft aanwijzingen hoe eigen bedrijfsdata veilig te gebruiken tijdens finetuning.
Kosten en inzetopties
De documentatie bespreekt ook kostenafwegingen: lokaal finetunen op een krachtige consumenten-GPU versus huren van cloud-GPU's. Het 8B-model is volgens IBM precies een pragmatische middenweg. Voor sommige teams blijft cloud-inzet aantrekkelijk vanwege schaalbaarheid en beheer, maar voor organisaties met privacy-eisen of die structureel eigen modellen willen beheren biedt lokaal finetunen een kosten- en privacyvoordeel.
| Model | Parameters | Gebruiksrichting |
|---|---|---|
| Granite 4.2 (small) | 3B | lichtgewicht taken, laag geheugenverbruik |
| Granite 4.2 (mid) | 8B | praktisch voor lokaal finetunen op één consumenten-GPU |
| Granite 4.2 (large) | 30B | hogere capaciteiten, grotere compute- en geheugenbehoefte |
De beschikbaarheid onder Apache 2.0 betekent dat bedrijven en onderzoekers de gewichten commercieel kunnen gebruiken mits de licentievoorwaarden gerespecteerd worden. Dat vergroot de kans dat Granite 4.2 zich snel verspreidt binnen onderzoeks- en commerciële projecten.
Wat ontwikkelaars moeten weten
Belangrijke praktische elementen uit de tutorial zijn het gebruik van QLoRA (4-bit-quantisatie) om geheugen te besparen, en het inzetten van PEFT/LoRA-adapters om alleen kleine aanpassingen te trainen in plaats van het volledige model. Daarnaast is er aandacht voor het opslaan van adapters en het samenvoegen met het basismodel, en voor export naar formaten die lokaal draaien via bestaande implementaties zoals llama.cpp of Ollama.
Voor Nederlandse ontwikkelteams en bedrijven betekent de release dat krachtige, aanpasbare taalmodellen nu binnen handbereik liggen zonder dat alle ontwikkeling via grote cloudaanbieders hoeft te lopen. Tegelijkertijd legt dat meer verantwoordelijkheid bij organisaties op het gebied van beveiliging en privacybeheer. Voor wie wil experimenteren is er nu een doorlopende gids die van A tot Z uitlegt hoe Granite 4.2 in de praktijk te brengen.