Meta heeft op 10 augustus 2026 Muse Glimmer vrijgegeven, een open‑weight taalmodel met 30 miljard parameters dat volgens de maker volledig lokaal kan draaien op een enkele consumenten‑GPU of op een Apple Silicon Mac. Het model vereist geen cloudabonnement, kent geen tokenkosten en stuurt volgens de documentatie geen data van het apparaat weg, factoren die voor veel Nederlandse ontwikkelaars en overheidsinstellingen relevant zijn.
Wat Muse Glimmer betekent voor lokale AI
De mogelijkheid om een krachtig groot taalmodel lokaal te draaien beïnvloedt drie concrete vragen die in Nederland hoog op de agenda staan: kosten, privacy en technische onafhankelijkheid. Voor teams die werken met persoonsgegevens of vertrouwelijke gegevens biedt lokaal draaien van modellen een manier om verwerking binnen de eigen infrastructuur te houden en zo de naleving van de Algemene Verordening Gegevensbescherming (AVG) te vergemakkelijken. Daarnaast kan het grote kostenvoordeel opleveren doordat API‑kosten en abonnementen wegvallen.
Installatie en gebruik: 13 stappen en meerdere runtimes
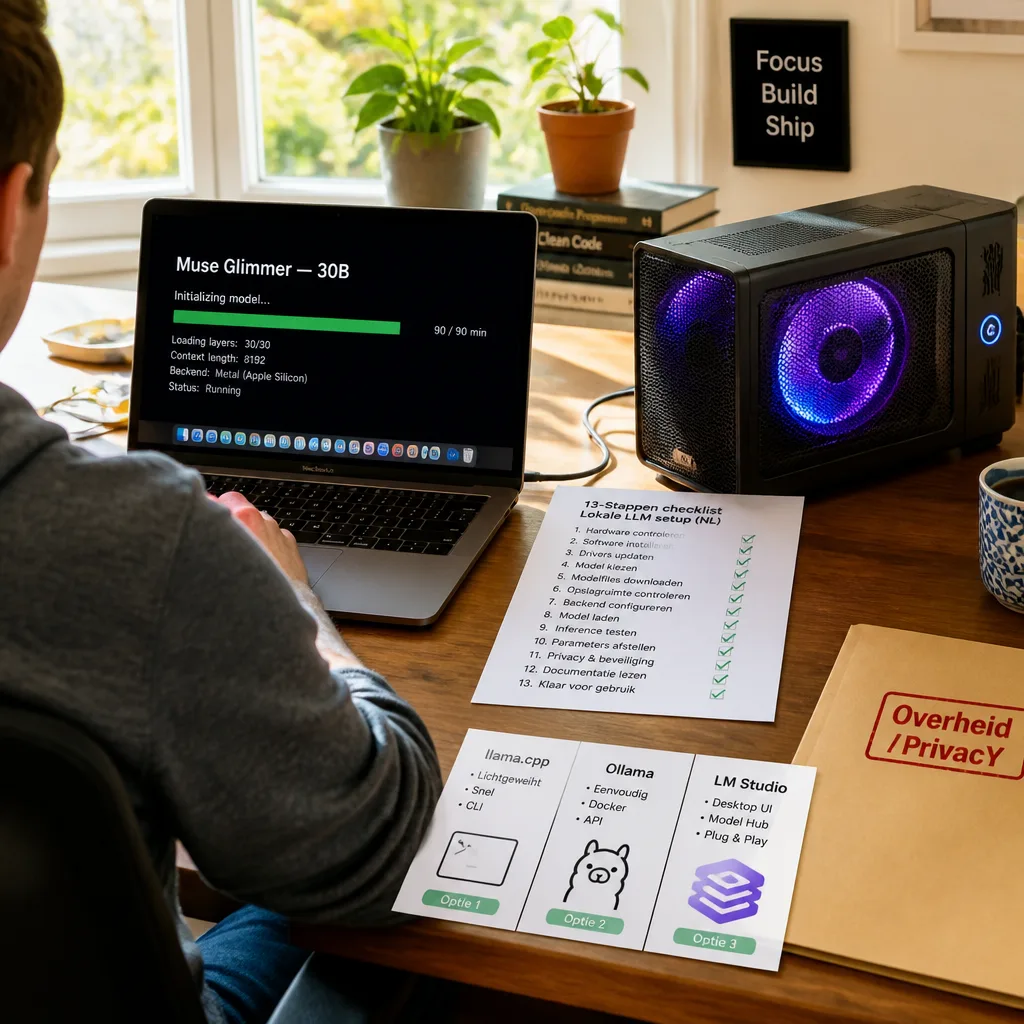
De publicatie gaat gepaard met een praktische handleiding die gebruikers in 13 stappen door het proces leidt, van het downloaden van de gewichtsbestanden tot het opzetten van een lokale agent. De makers geven een geschatte doorlooptijd van ongeveer 90 minuten, afhankelijk van downloadsnelheid en of gebruikers zelf components compileren.
- Voorbereiding van hardware en software
- Download van Muse Glimmer via Hugging Face
- Converteren en kwantiseren met llama.cpp
- Draaien via twee serveroplossingen en een commerciële runtime
- Voorbeelden, troubleshooting en een praktijkproject voor een lokale agent
Drie manieren om het model te draaien
De tutorial beschrijft drie verschillende uitvoeringen waarmee ontwikkelaars Muse Glimmer kunnen inzetten: via llama.cpp, via Ollama en via LM Studio. Elk van deze opties heeft eigen voor‑ en nadelen op het vlak van prestaties, beheer en gebruiksgemak.
| Uitvoeringsoptie | Kenmerk |
|---|---|
| llama.cpp | Converteren en kwantiseren; lage‑level control |
| Ollama | Gebruiksvriendelijke runtime voor lokale servers |
| LM Studio | Ontwikkelomgeving voor modelintegratie en prototyping |
Praktische aandachtspunten en beperkingen
Hoewel lokaal draaien veel voordelen biedt, noemt de handleiding ook veelgemaakte fouten en acht specifieke troubleshootinggevallen die ontwikkelaars kunnen tegenkomen. Belangrijke aandachtspunten zijn onder meer de compatibiliteit met verschillende GPUs, conversie‑stappen voor de gewichten en technieken als kwantisatie en speculative decoding om prestaties te optimaliseren.
Voor Nederlandse organisaties is de timing opvallend. Dit jaar experimenteren diverse overheidsinstanties al met lokaal draaiende taalmodellen, variërend van interne chattools tot onderzoeksprojecten. Lokaal draaiende modellen sluiten aan op een bredere belangstelling voor data‑soevereiniteit en het verminderen van afhankelijkheid van buitenlandse clouddiensten.
Wat gebruikers moeten overwegen
De publicatie bevat een sectie over licentie en kosten, en geeft richtlijnen wanneer lokaal draaien zinvol is en wanneer cloudoplossingen verstandiger blijven. Voor veel kleinere teams kan de technische complexiteit en het beheer van lokale infrastructuur nog een drempel vormen; grotere organisaties en projecten met strenge privacy‑eisen kunnen er juist direct voordeel uit halen.
Voor ontwikkelaars die willen experimenteren biedt Muse Glimmer een concrete, technisch toegankelijke route om krachtige generatieve AI te benutten zonder voortdurende externe kosten of dataverkeer naar externe servers. De handleiding en de drie beschreven runtimes moeten helpen bij een snelle eerste installatie, maar het blijft verstandig om bij productie‑gebruik aandacht te besteden aan beveiliging, updates en modelbeheer.
Belangrijk: de release van Muse Glimmer verandert de spelregels voor wie AI binnen de eigen infrastructuur wil houden, maar het succes hangt af van praktische implementatie, beschikbare hardware en organisatorische keuzes over beheer en privacy.